重新理解 RAG:长上下文为什么没有取代检索增强生成
2025 年,RAG 经常被放在「存废之争」里讨论:长上下文窗口越来越大,会不会有一天不再需要检索?Agent 编排火了以后,RAG 是不是旧范式?
但真正在做企业 AI 的团队给出了相反的答案:他们投入更深、更系统化了。原因不复杂——RAG 不是给大模型打的一块补丁,而是把私域知识接进智能系统的数据基础设施。模型可以换,Agent 编排可以变,「如何把最相关、最新、可治理的信息,以可接受的成本喂给模型」这个问题一直存在。这正是 RAG 的立身之本。
这篇先把传统 RAG 的标准流水线讲清楚:它是怎么工作的,文档解析这块最脏最累的活儿难在哪,以及它天然的五个短板。
标准 RAG 的两条链路
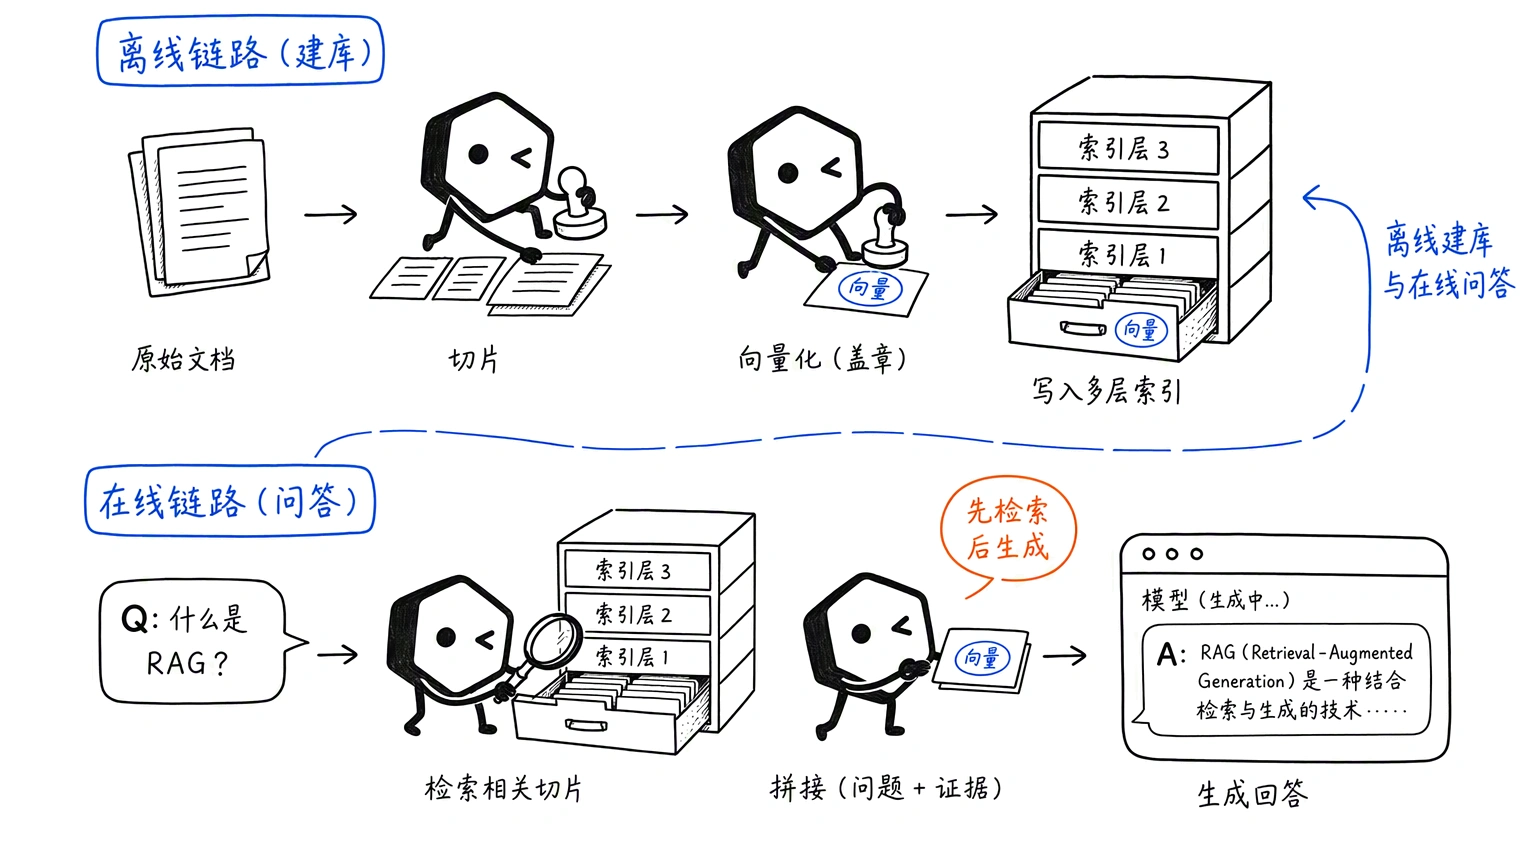
一套最经典的 RAG 系统,可以拆成「离线建库」和「在线问答」两条链路。
离线建库(Ingestion):
原始文档 → 解析(Parse)→ 切分(Chunk)→ 向量化(Embed)→ 入库(Index)
- 解析(Parse):把 PDF、Word、Excel、PPT、扫描件、网页等异构格式,统一转成结构化或半结构化文本。这是全链路最容易被低估、却最影响最终效果的一环,后面单独展开。
- 切分(Chunk):把长文档切成适合检索的片段。固定长度、按段落、按语义边界等策略各有取舍。
- 向量化(Embed):用 Embedding 模型把每个片段映射为高维向量。
- 入库(Index):向量写入向量数据库(如 ES、Milvus、pgvector、Faiss),同时通常保留原文与元数据。
在线问答(Query):
用户问题 → 查询改写 → 检索(召回)→ 重排(Rerank)→ 组装 Prompt → LLM 生成 → 引用溯源
- 查询改写:同义扩展、多路 query、HyDE(假设性文档生成)等,提升召回。
- 检索/召回:向量检索(语义)与关键词检索(BM25/精确匹配)结合,即混合检索(Hybrid Search)。
- 重排(Rerank):用 Cross-Encoder 等更重的模型对召回结果精排,大幅提升 Top-K 精度。
- 生成 + 溯源:把检索片段拼进 Prompt,让模型基于证据作答,并回带引用来源以支持可追溯。
一句话总结:传统 RAG = 「先检索,后生成」。它用一次向量相似度加关键词搜索,换来「无需重训模型即可注入私域知识」的能力。
在企业法务场景中,知识检索需要关联授权资料与法律依据,供法务复核;在教育行业方案中,知识库则与教学、科研和师生自建智能体结合。两类场景都需要把资料接入具体任务。
被低估的主战场:文档解析
在真实企业环境里,大部分效果问题最终都能追溯到文档解析这一层。垃圾进,垃圾出。
难在哪
- 复杂版式:图文混排、多栏排版、页眉页脚、脚注、水印、目录;
- 表格:合并单元格、跨页表格、无线框表格——传统 OCR 极易把行列关系解析错乱;
- 图片与图表:产品示意图、流程图、架构图承载关键信息,纯文本管线会直接丢掉;
- 公式与专业符号:金融、科研、工程文档中的公式无法用普通文本表达;
- 扫描件与低质量文档:倾斜、模糊、印章遮挡。
两条技术路线及其权衡
| 路线 | 代表做法 | 优势 | 短板 |
|---|---|---|---|
| 工程化解析 | 规则 + 版面分析 + 传统 OCR | 快、成本低、可控 | 复杂版式易崩,泛化差 |
| 模型化解析 | OCR 大模型 / 多模态大模型端到端解析 | 复杂版式精度高,能识别图表公式 | 慢、贵、算力开销大 |
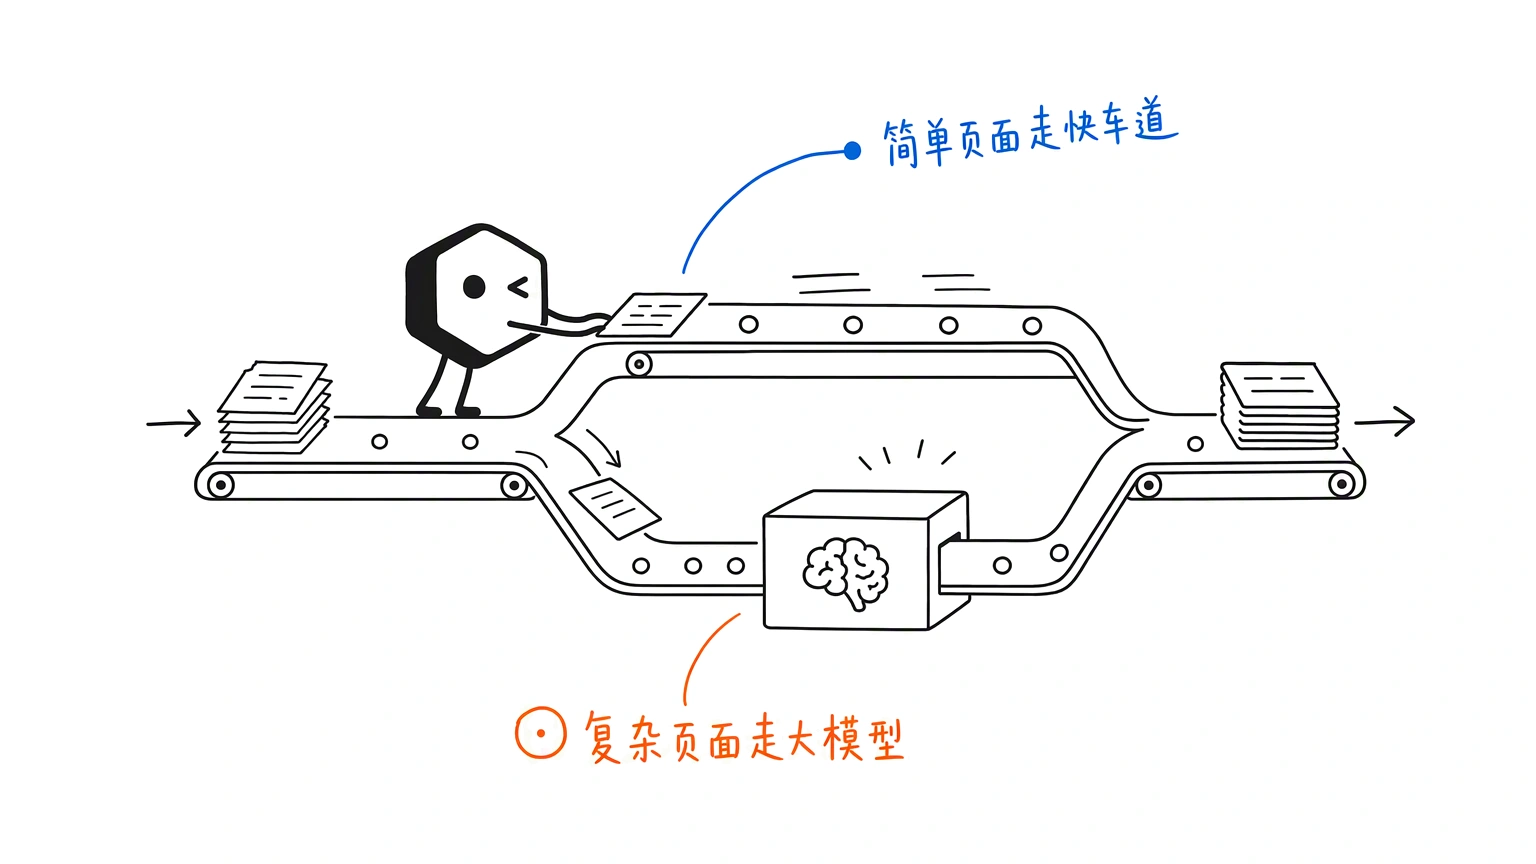
关键洞察:没有银弹。成熟做法是动态路由——先判断页面复杂度,简单页面走工程链路保速度和成本,复杂页面走模型链路保精度。
这也是 腾讯云 ADP 知识库 在复杂文档解析场景中采用的工程思路之一,本系列第二篇会展开。
切分策略:一个结构性矛盾
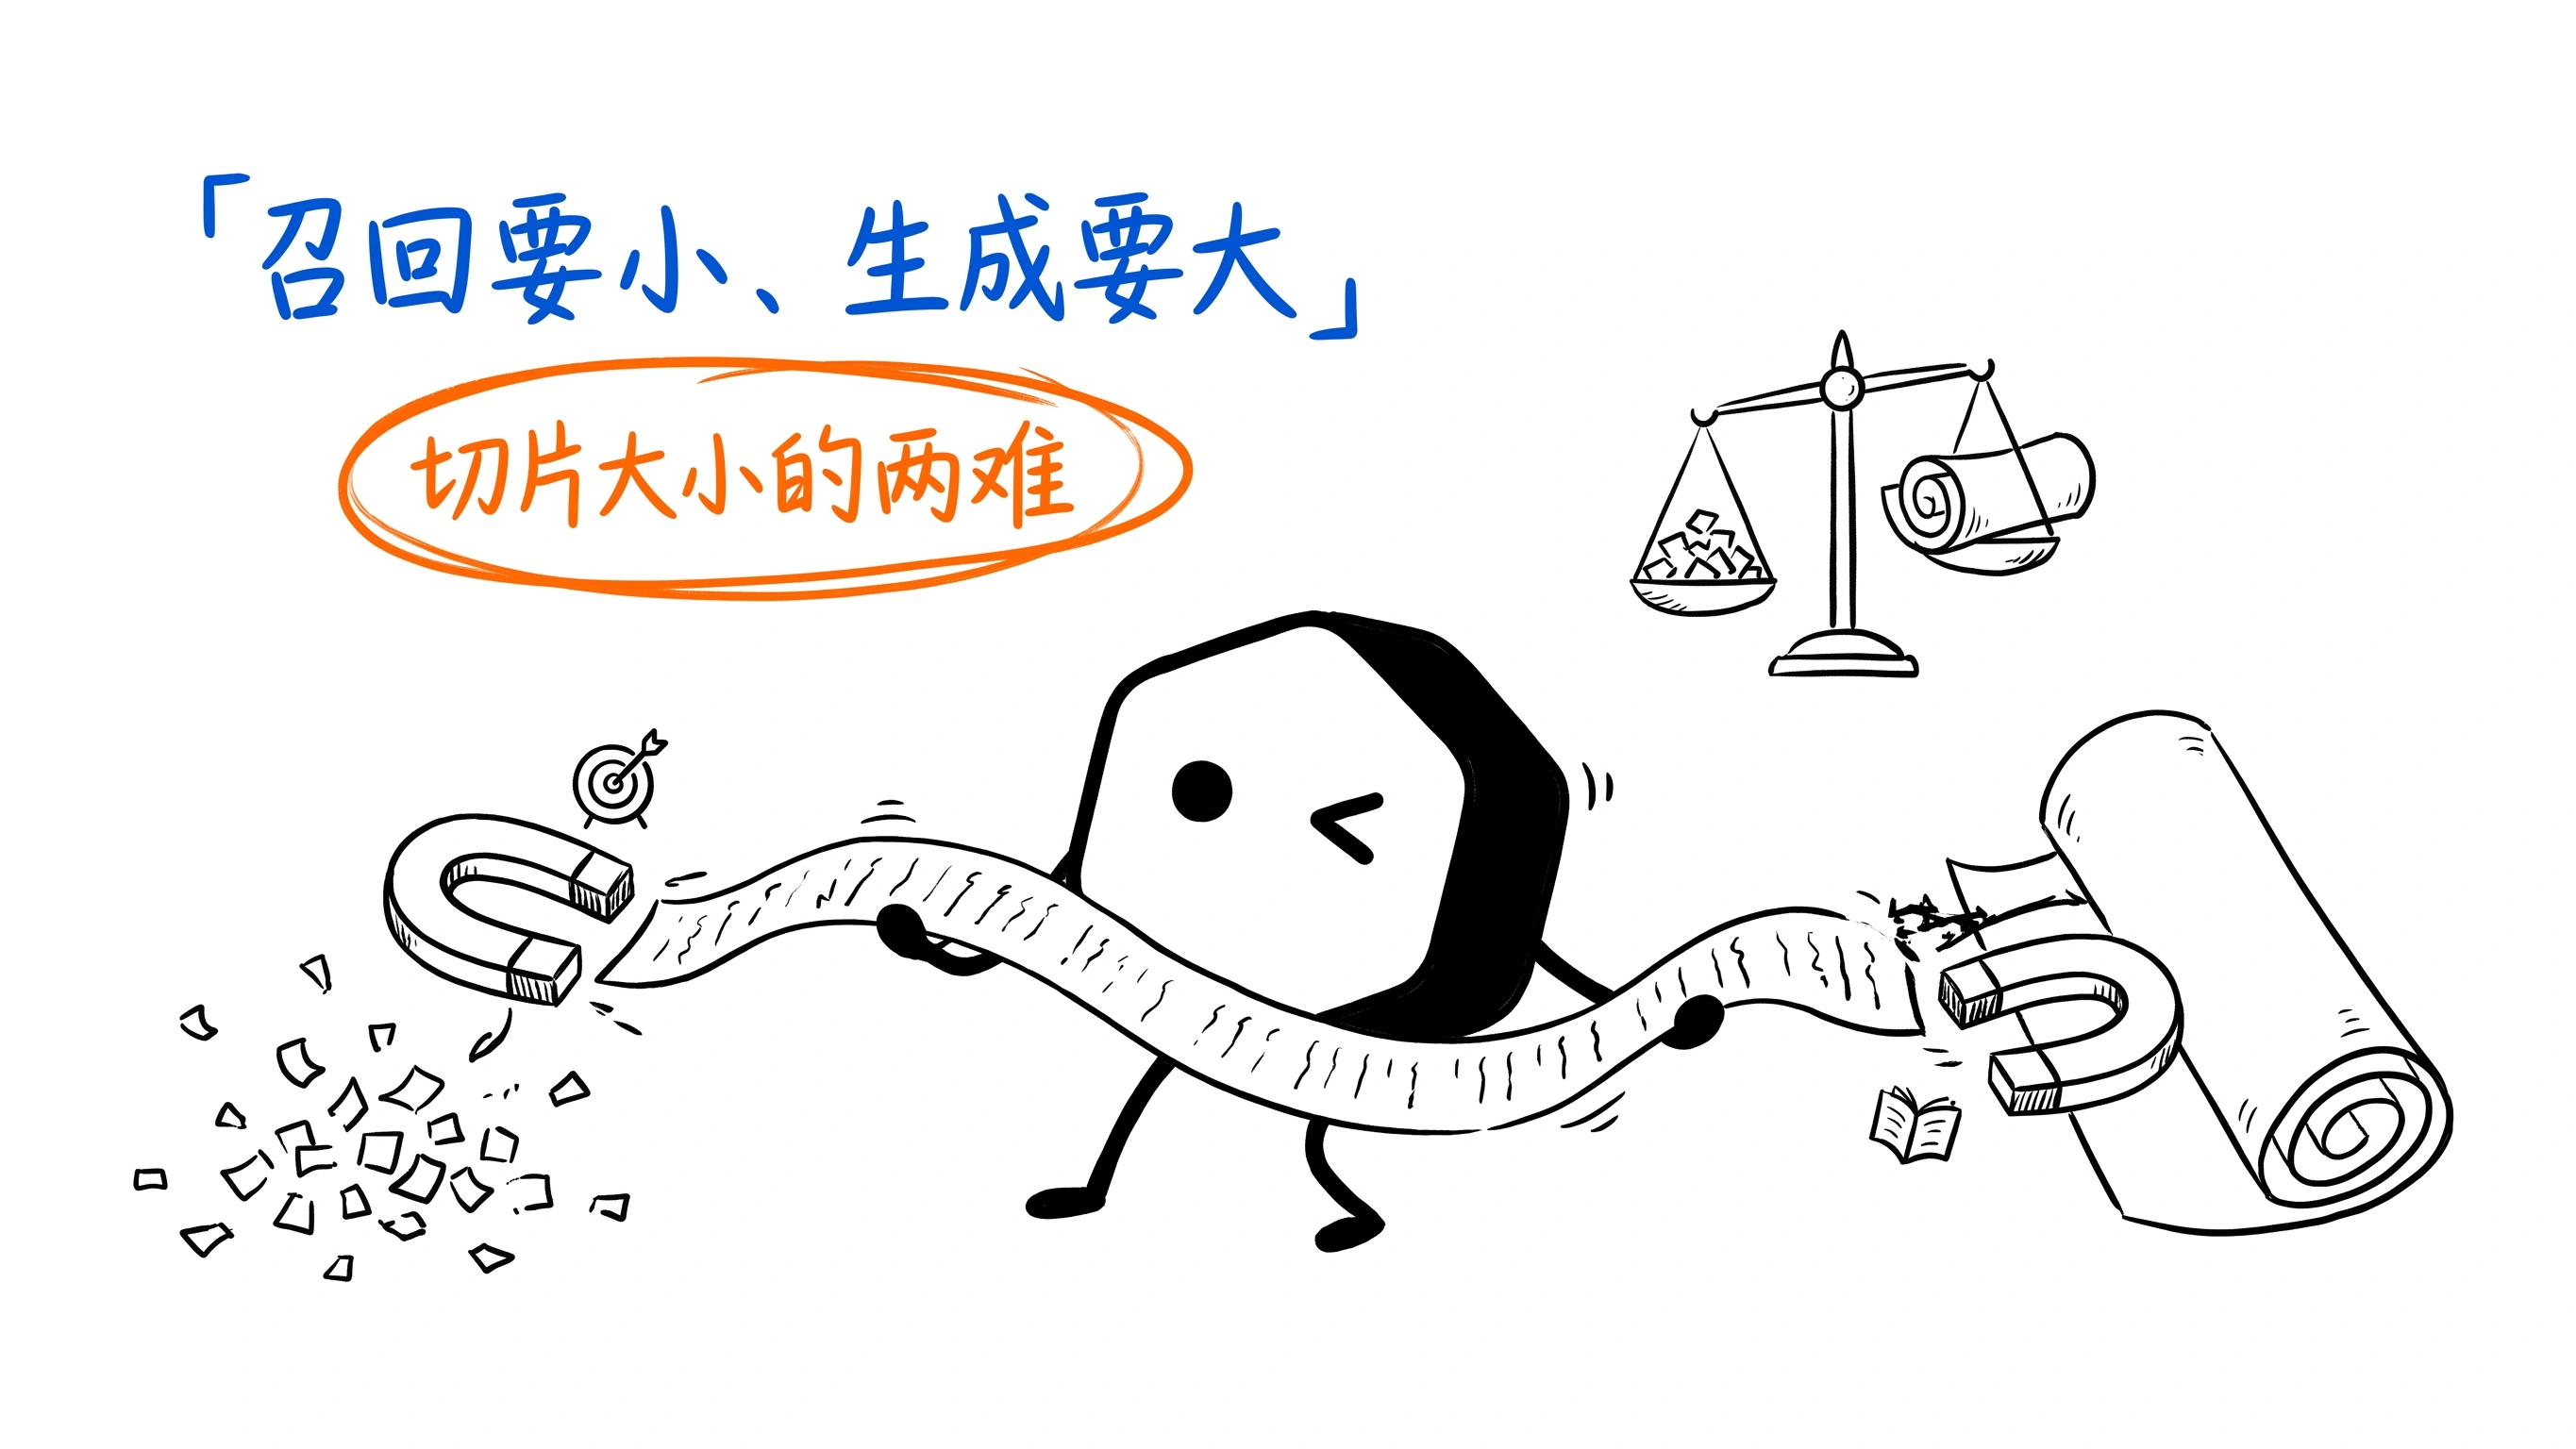
固定粒度切分存在无法调和的矛盾:
- 为了召回准,片段要小(100~256 token),语义焦点集中;
- 为了生成好,片段要大(1024+ token),上下文完整。
小切片检索准但碎片化,模型看不到全貌;大切片完整但引入噪声、降低检索精度。这个矛盾正是后来 TreeRAG、父子分块、语义分块等技术要解决的核心问题,本系列第三篇会回到它。
传统 RAG 的五个天然短板
盘点完标准范式,也要诚实地列出它的边界。
1)单跳检索的局限。 一次检索、一次生成。面对需要多步推理、跨多个文档综合的复杂问题(比如「列出计租面积大于 100 平的所有商户,并附档案摘要和竞争关系」),单跳检索往往只能给出残缺答案。
2)切片碎片化。 上一节提到的矛盾带来的「Lost in the Middle」问题——关键信息被淹没在拼接片段的中间位置。
3)结构化数据无力。 面对 Excel、数据库,纯向量检索难以做精确的条件筛选与聚合。「分数最高的是谁」「湖南有多少家门店」这类问题,语义相似度帮不上忙。
4)时效性缺失。 更麻烦的不是忘了重建索引,而是新旧版本共存时,检索会把过期的那份也召回甚至优先召回。举个例子:一条 2025 年的法规,2026 年出了修订版,两份文档都在库里。用户问的时候期望命中 2026 版,但向量检索只看语义相似度、不看时间,很可能召回 2025 的旧版。
5)被动检索。 不管问题需不需要、需要检索几次,系统都机械地检索一次。
这些短板,正是从传统 RAG 走向 Agentic RAG 的驱动力。企业级平台怎么把它们逐个补齐,可以在企业级 RAG 的工程解法中继续查看;而跨文档推理、评测、知识治理这些更难的硬骨头,放在第三篇。
先回答那个问题:长上下文会杀死 RAG 吗
既然短板这么多,为什么不干脆把全部知识塞进越来越大的上下文窗口?先把结论放在这里:检索负责把「对的」信息找出来,长上下文负责把找出来的信息「装得下」——两者是协同而非替代。检索挑不对,再大的窗口也是垃圾进垃圾出;窗口装不下,再准的检索也只能给模型喂碎片。
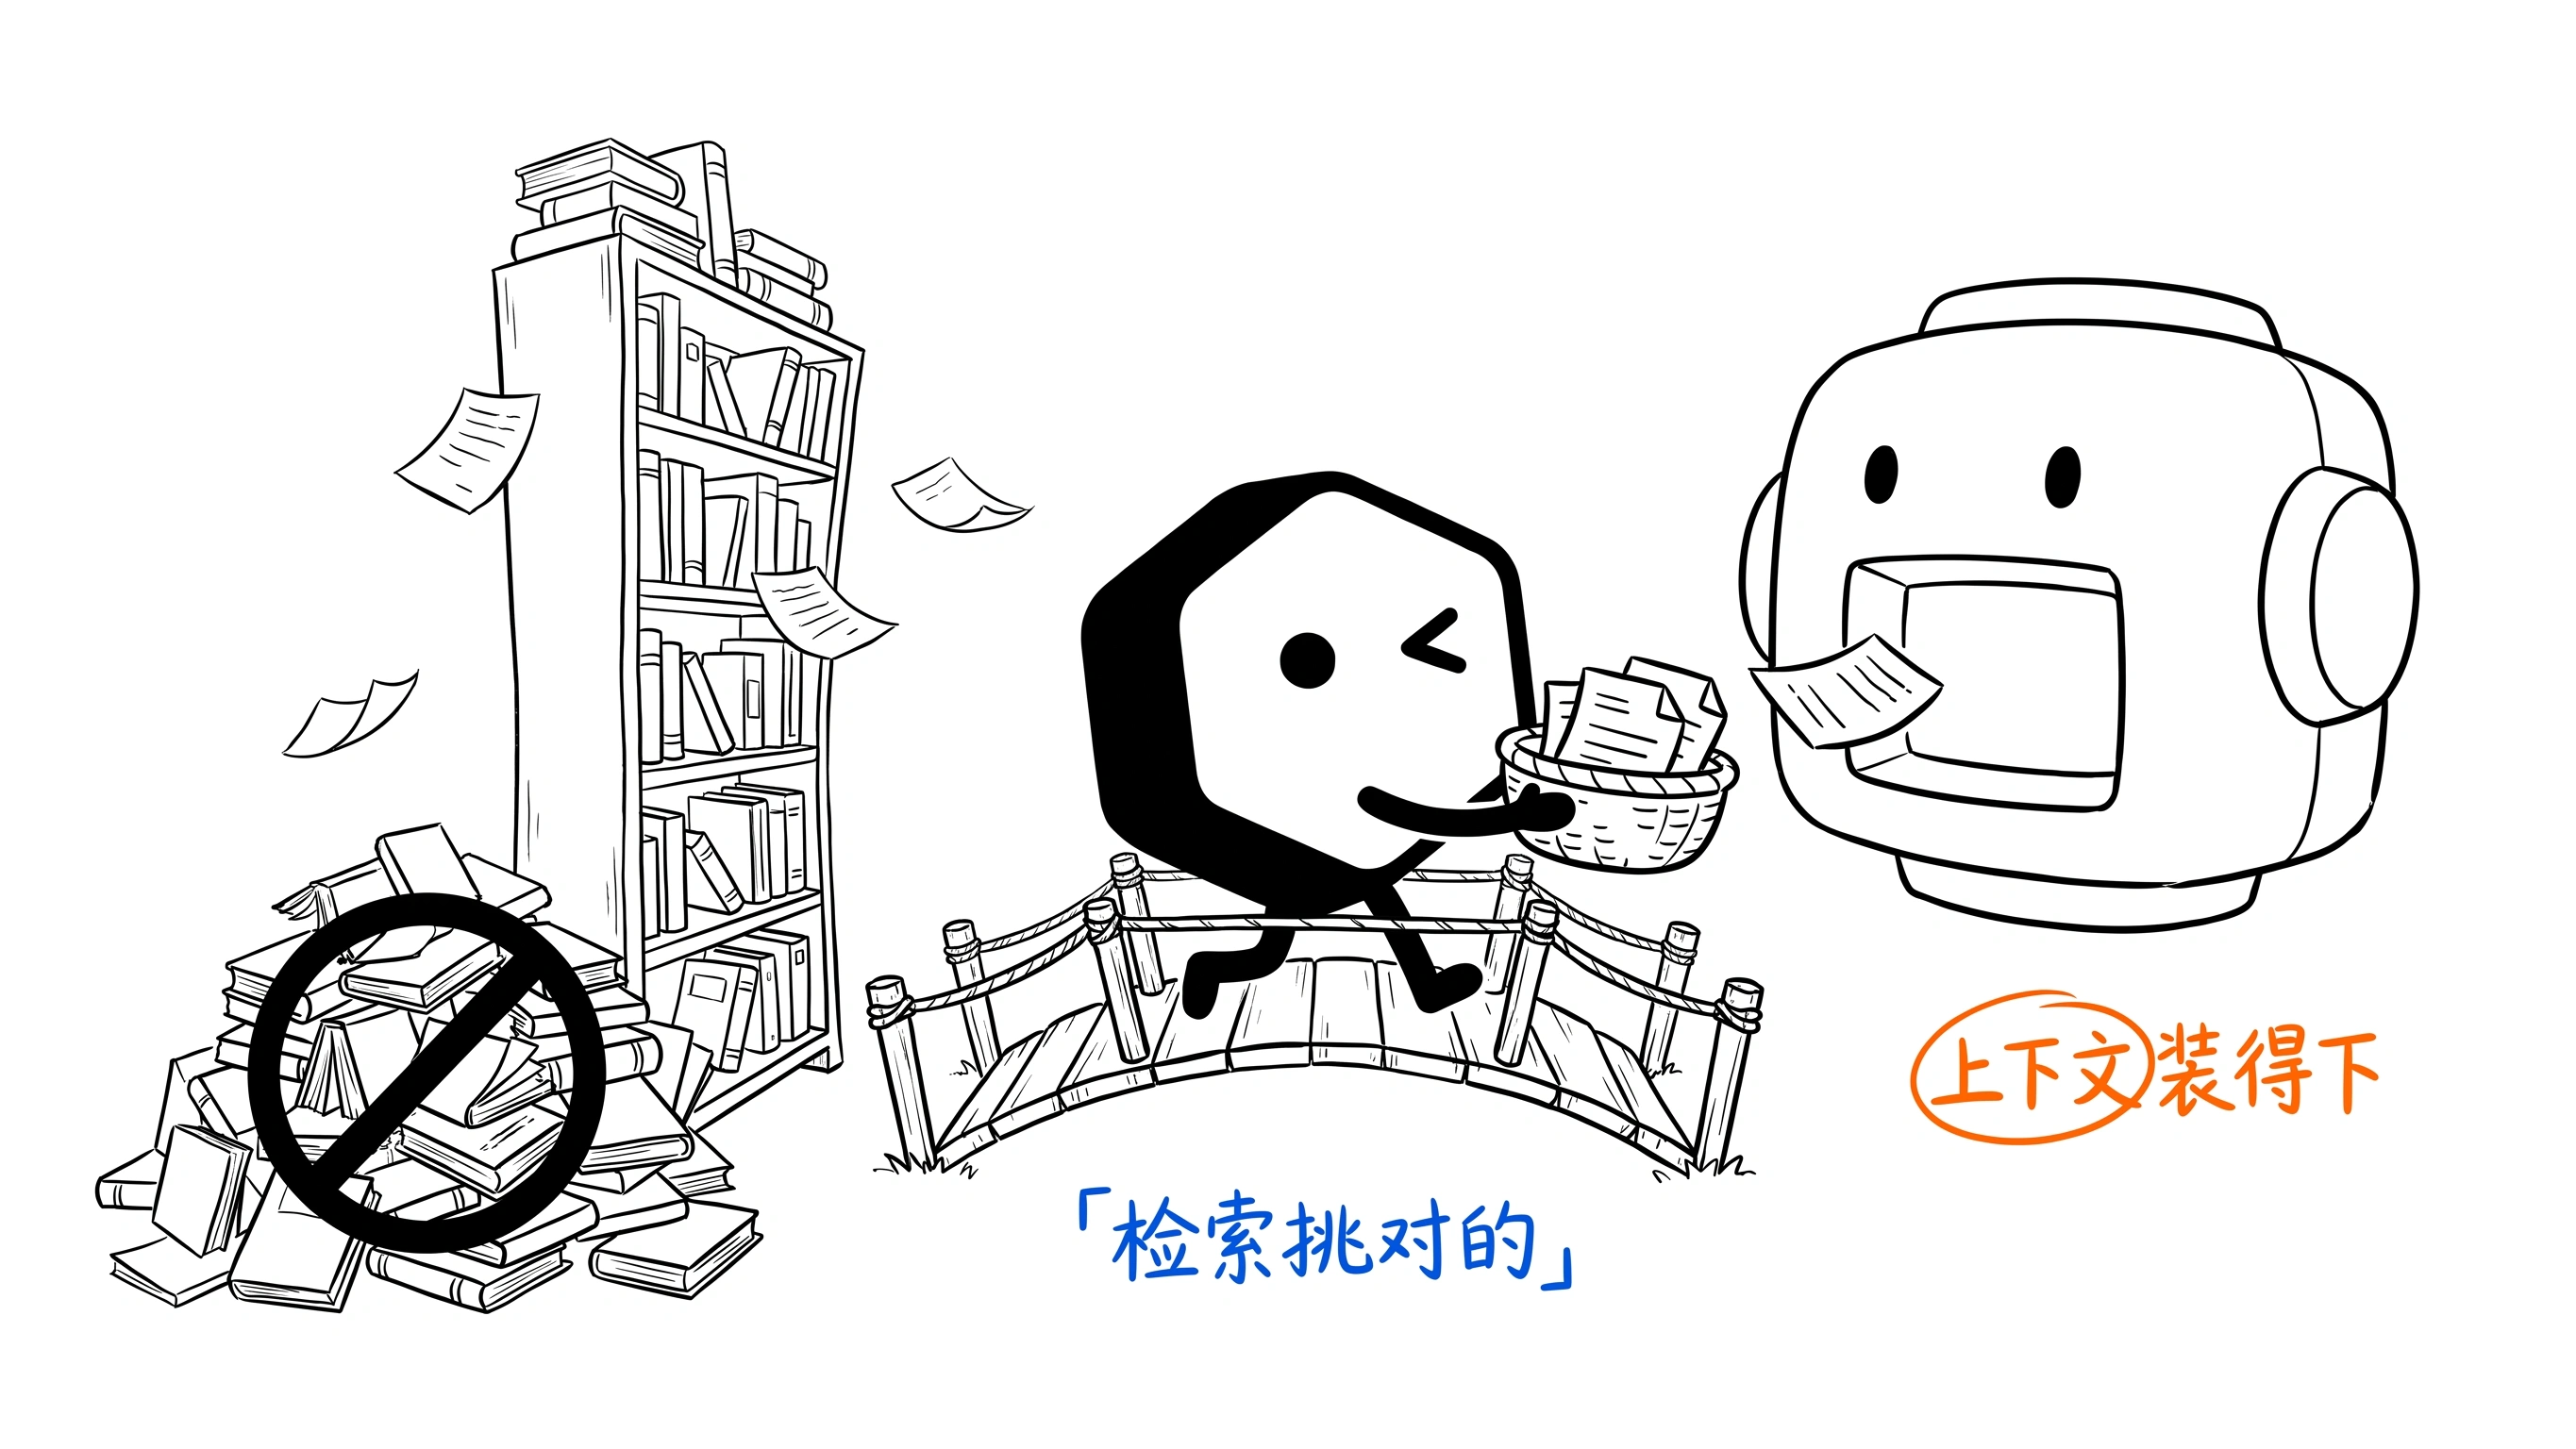
这个判断的完整论证——包括暴力堆料的注意力稀释问题、「Lost in the Middle」的成本曲线、以及 Context Engineering(上下文工程)这个新领域的由来——在评测、知识治理与上下文协同一篇中展开。这里先立个锚点:后文所有讨论,都建立在「检索与上下文协同」这个前提上。
结语:RAG 不是被取代,而是在演进
回到开头的问题:长上下文会不会取代 RAG?答案是否定的,但两者的关系不是替代,而是协同——这背后有一整套工程逻辑,第三篇会给出完整论证。
先把地基打好:理解标准流水线和它的短板,是评估一切「RAG 优化方案」的前提。下一篇,我们以 腾讯云智能体开发平台(ADP) 为样本,看一套在实际业务与落地场景中持续打磨与验证的工程解法,如何把文档解析、Text2SQL、GraphRAG、时效性检索这些短板逐个补齐。
开始构建知识助手
拿一份业务说明书或制度文档,按文档导入指南建立知识库,再用真实问题检查回答和引用来源。进入 ADP,开始构建。
相关阅读