Jev对比通用大模型:自动判断任务怎么选
导语
TypeSafe AI 近期发布 Jev,并将其定义为面向软件自动化的 System One Model。与面向对话、写作、总结、推理解释的通用大模型相比,Jev 的产品定位更窄:只做判断,返回可被程序直接消费的类型化结果、概率与置信度。
这类模型的出现,指向企业 AI 落地中的一个高频问题:很多任务并不需要模型写一段文字,而是要模型快速回答“分到哪个队列”“是否需要人工复核”“风险等级是多少”“这条内容能不能通过”。在工单路由、内容预筛、线索分级、质检判定、审核分流等场景中,判断结果往往会进入后续流程,影响自动处理、人工复核与升级转派。
本文围绕 Jev 热点,结合公开信息、接入方式与一组基于腾讯云 ADP 的工单分流对比实验,讨论高频判断模型与通用大模型的边界:什么时候该用 Jev 这类自动判断模型,什么时候仍应选择通用大模型,以及如何通过 腾讯云 ADP 这类 AI 应用开发平台,把判断能力编排进可观测、可评测、可治理的业务流程。
核心要点
- Jev 的核心定位是“结构化自动判断”:输入状态与问题,输出类型化结果、概率和置信度。
- 官方与接入指南口径显示,Jev 主打低延迟、低成本、输出 Token 免费,适合高频决策任务。
- Jev 支持 Choice、Score、Noul 三类核心问题,分别覆盖多选一分类、量表打分与布尔概率判断。
- 通用大模型在语义理解、解释生成、多步骤推理、回复生成方面仍具优势,适合开放式任务。
- 在 ADP 工单分流实测中,Jev 在成本和速度上优势明显,准确率接近通用大模型,但存在少量空响应和特定类别误判。
- 企业选型不应只看单次准确率,还要评估输出形态、阈值分流、失败兜底、评测闭环和后续工作流编排。
1. Jev 的定位:面向机器消费的判断模型
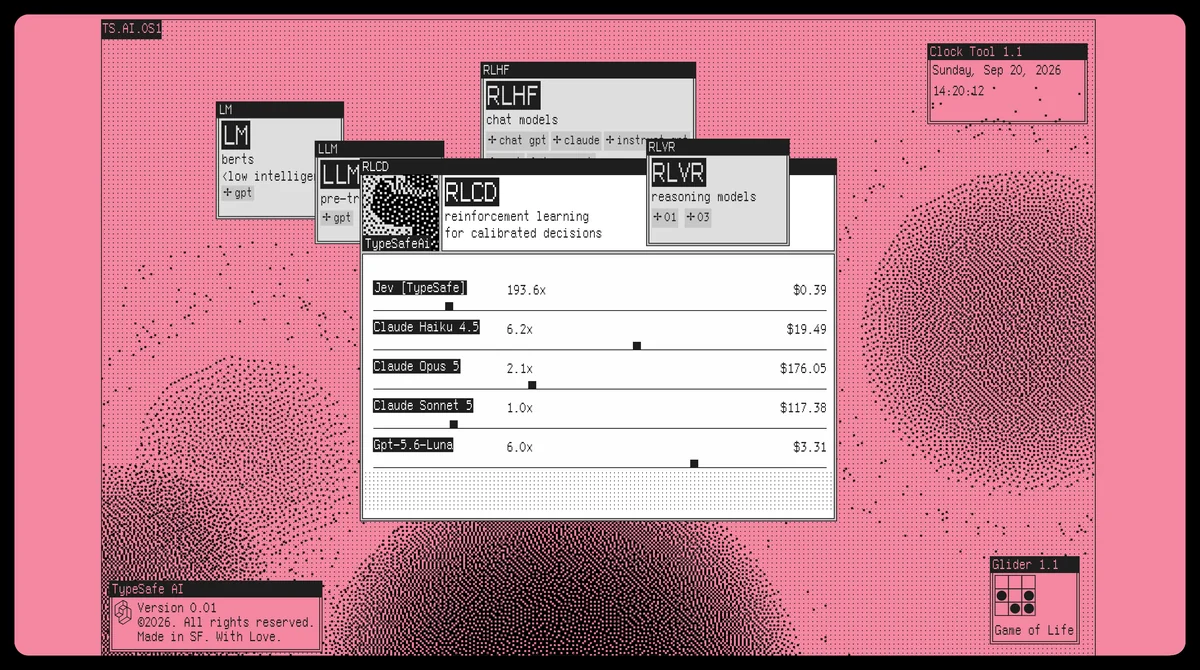
根据 TypeSafe AI 官网介绍,Jev 属于 System One Models,强调“Decisions, not strings”。它面向软件自动化场景,返回 typed decisions,并附带 calibrated probabilities。换句话说,Jev 主要解决的是“让系统根据模型判断继续执行”的问题。
接入指南中对 Jev 的描述更偏工程化:它放弃文本生成和对话能力,专注于极速自动化决策,目标延迟为 70-500ms,价格为输入 $0.042/百万 token,输出免费,并强调结构化输出与置信度能力。TypeSafe AI 官网也展示了相近的成本口径:$42/Billion input tokens。
这与通用大模型的设计目标不同。通用大模型通常面向自然语言交互,擅长把复杂语境转化为解释、摘要、建议、代码或多轮对话。即便使用 JSON Mode 或结构化输出约束,本质上仍是在生成模型上施加格式要求。Jev 的思路则是把问题收敛到判断任务:软件给出状态和问题,模型返回可执行的判断结果。
对企业来说,这种差异会影响三件事:
- 输出是否可直接入流:判断结果能否被后续规则、工作流、数据库字段消费。
- 不确定性是否可治理:模型能否给出概率或置信度,让业务设置灰度区间。
- 高频调用成本是否可接受:当每天需要判断十万条、百万条请求时,单位成本会显著影响方案可行性。
2. 三类核心交互:Choice、Score 与 Noul
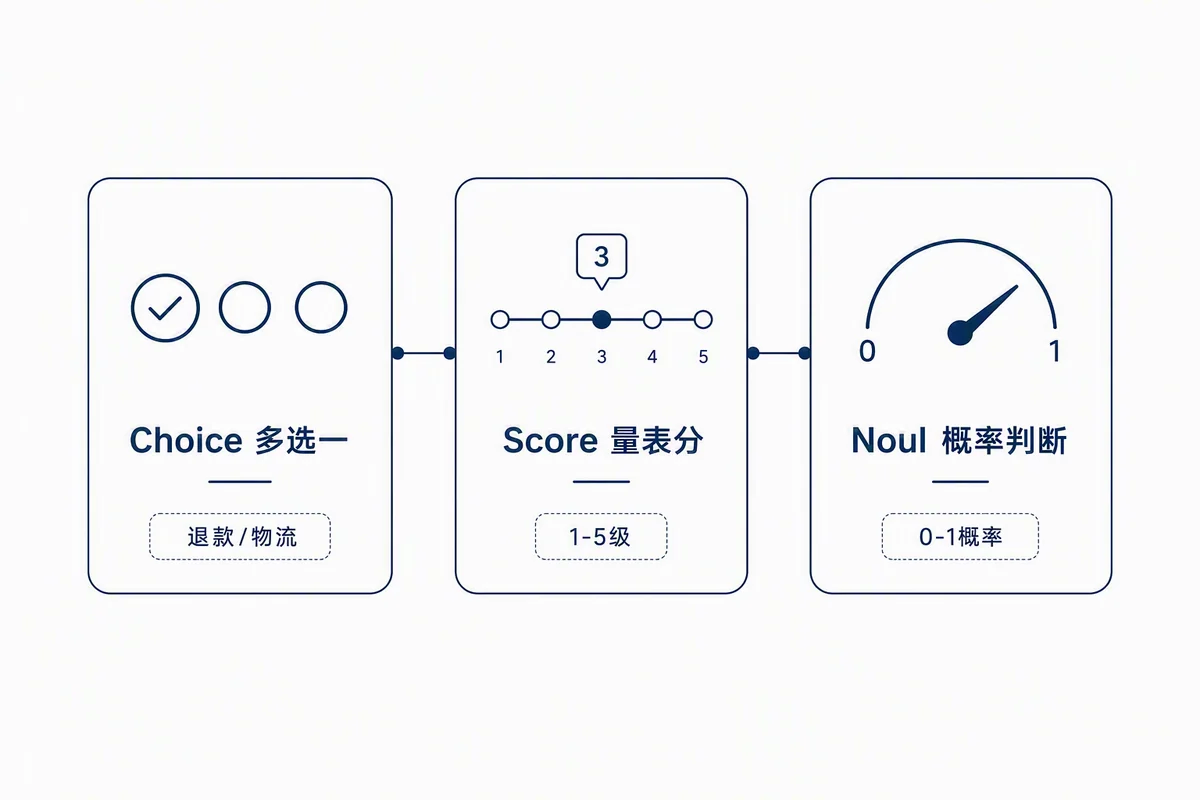
Jev 的核心交互被抽象为三类问题。这种设计让自动判断任务更接近软件接口,而不是自然语言问答。
Choice:多选一分类
Choice 用于从最多 255 个选项中选择最符合的选项,并返回概率。典型场景包括:
- 工单意图分类:退款、物流、账务纠纷、技术故障、投诉。
- 内容类别识别:营销、新闻、评论、违规风险、用户反馈。
- 线索行业判断:教育、医疗、贸易、媒体、法律等。
如果企业在做媒体内容分发或内容审核,Choice 可以用于内容预筛和频道路由;在 ADP 媒体解决方案 这类场景中,类似判断通常需要与后续审核、分发、归档流程联动。
Score:级限量表打分
Score 用于在 2~10 级的自定义语义轴线上打分。典型场景包括:
- 客户情绪等级:平静、不满、愤怒、暴怒。
- 风险严重程度:低、中、高、极高。
- 质检缺陷等级:轻微、一般、严重、致命。
在工业质检中,模型往往要先给出缺陷等级,再决定是否进入人工复核或停线处理。类似场景可参考 ADP 质检解决方案 的流程化落地思路。
Noul:布尔概率判断
Noul 用于判断一个陈述是否为真,并返回 0 到 1 之间的概率。它适合回答“是否满足某个业务条件”:
- 用户是否明确表达退款意愿。
- 内容是否包含敏感风险。
- 工单是否需要转人工。
- 合同条款是否存在特定风险点。
在智能法务场景中,Noul 可以用于条款预筛、风险命中判断和复核分流,再交给更擅长文本解释的模型生成审查意见。类似流程可结合 ADP 法律解决方案 进行编排设计。
3. 注册与接入:从官方白名单到第三方网关
目前,Jev 仍处于早期访问阶段。根据接入指南,可通过以下路径尝试接入:
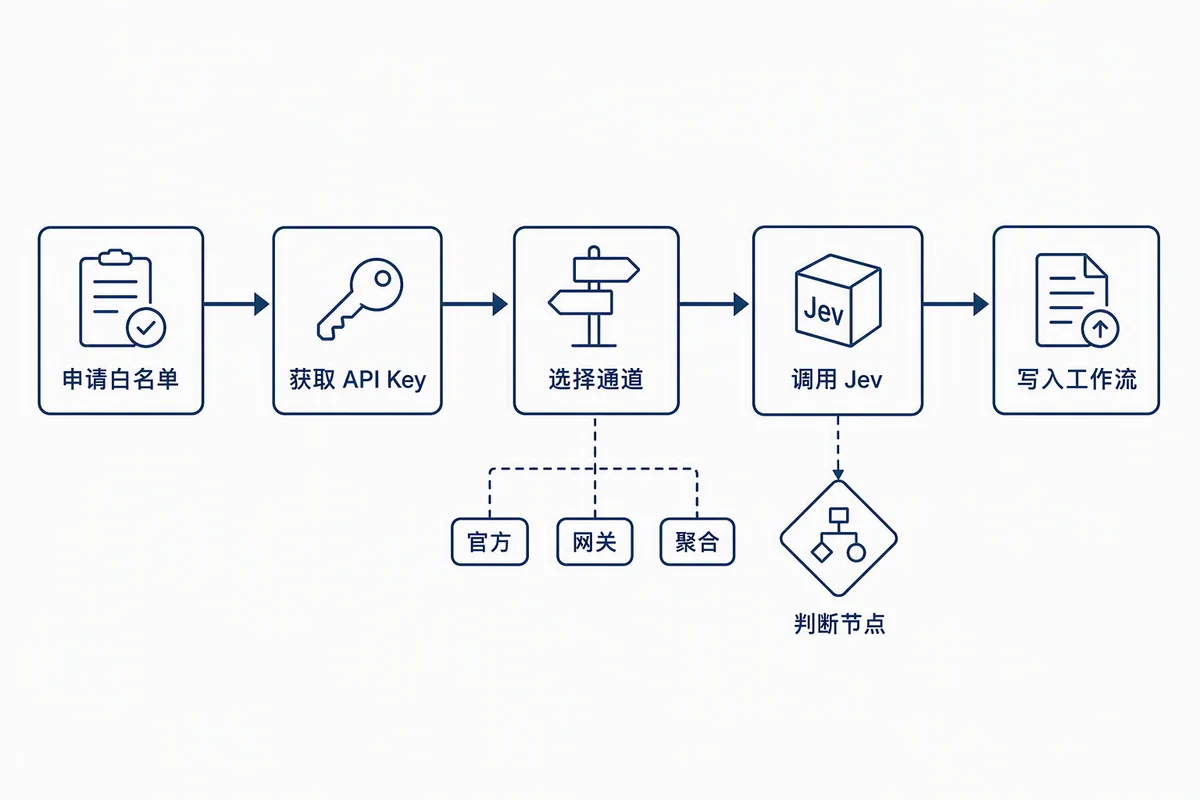
- 官方通道:访问 TypeSafe AI Console 登录并申请加入 Waitlist,审核通过后在设置中生成
TYPESAFE_API_KEY。 - 第三方托管直连:通过 Vercel AI Gateway 或 Cloudflare Workers AI 调用,模型 ID 为
typesafe/jev。 - 聚合平台调用:在 OpenRouter 使用
typesafe/jev-latest,计费口径与官方保持一致。 - 快捷体验:访问 TryJev Playground 进行免 Key 在线测试和可视化体验。
接入形态上,Jev 更像一个判断接口。下面是接入指南中的极简调用示例,实际端点、鉴权方式和字段结构应以官方文档或所选网关文档为准:
import requests

response = requests.post(
    "https://typesafe.ai",
    headers={
        "Authorization": "Bearer YOUR_API_KEY",
        "Content-Type": "application/json"
    },
    json={
        "model": "jev-latest",
        "state": "用户工单:我的银行卡被重复扣款了两次,请立刻退款!",
        "questions": {
            "routing": {
                "type": "choice",
                "options": ["退换货", "物流", "账务纠纷"]
            },
            "is_refund": {
                "type": "noul",
                "criteria": "用户明确表达了退款意愿"
            }
        }
    }
)

print(response.json())
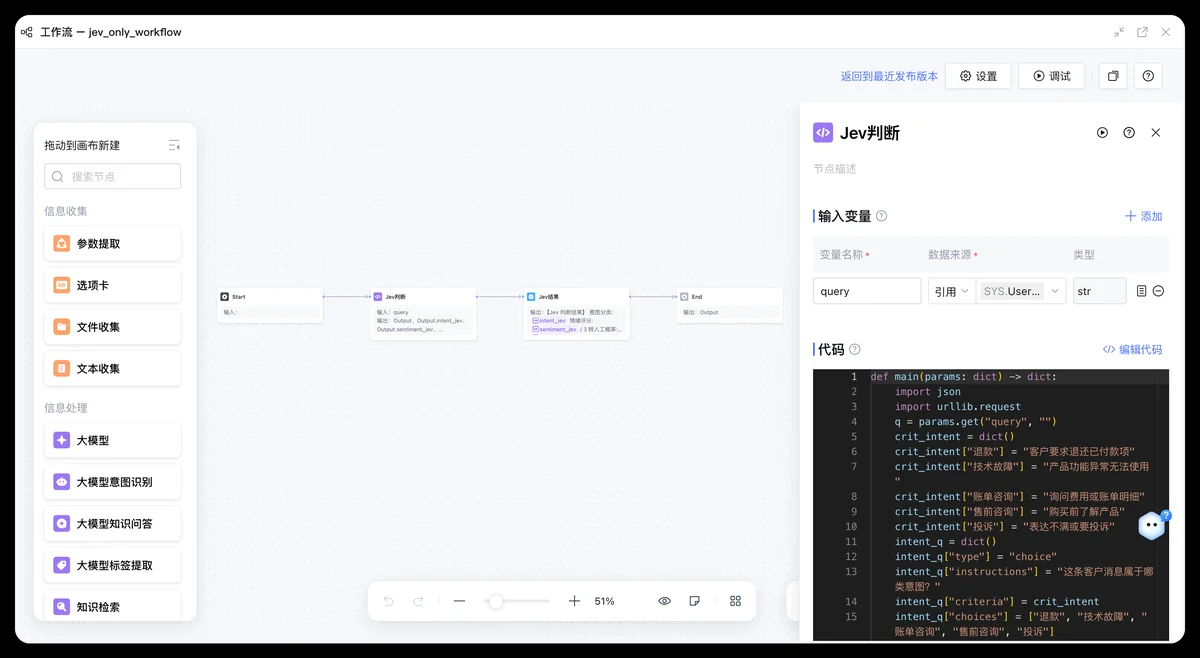
从工程视角看,这种接口形态适合放在工作流节点中:前置节点负责取数和清洗,中间节点调用 Jev 判断,后置节点根据概率阈值路由到自动处理、人工复核或转人工队列。
4. 与通用大模型对比:看准确率,也看输出形态
企业做大模型选型时,容易把问题简化为“哪个模型更准”。但在自动判断任务中,准确率只是一个维度,至少还要比较速度、成本、稳定性、输出结构和后续治理能力。
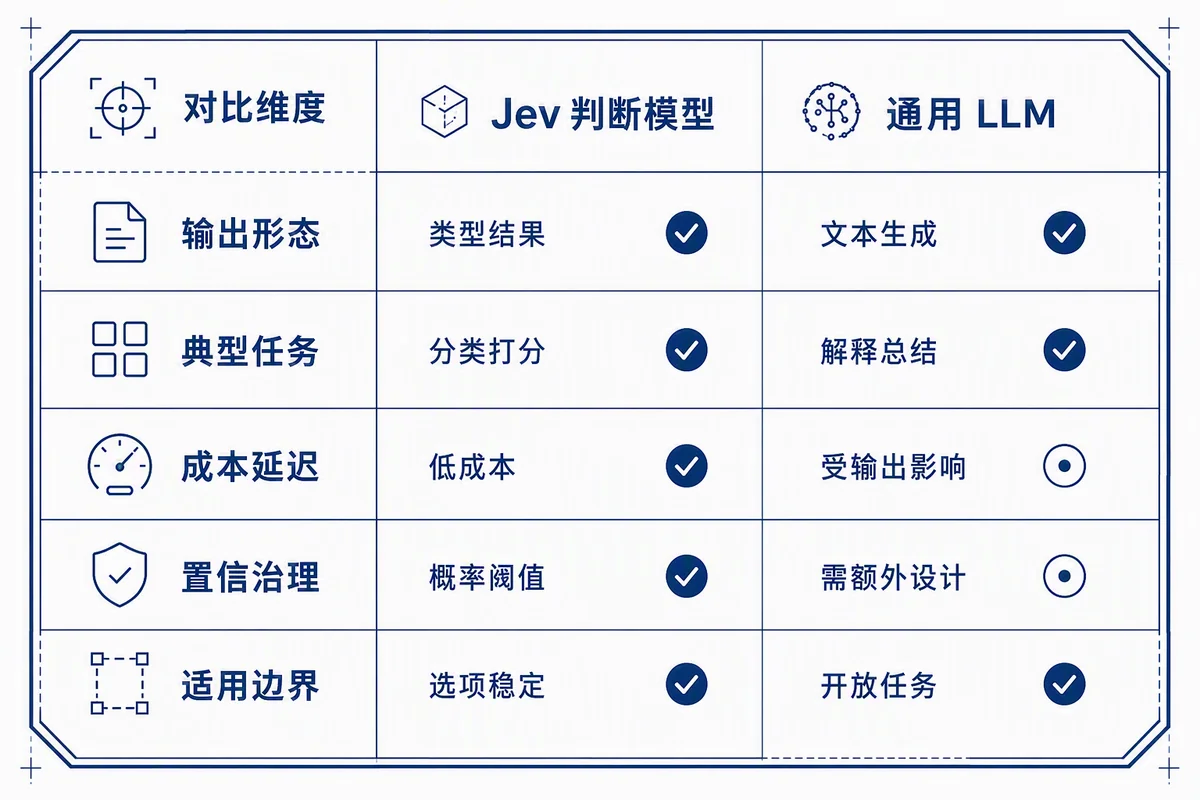
| 维度 | Jev 这类判断模型 | 通用大模型 |
|---|---|---|
| 主要输出 | 类型化判断、概率、置信度 | 文本、JSON、解释、摘要、建议 |
| 典型任务 | 分类、打分、是否命中、预筛、路由 | 对话、写作、总结、复杂推理、回复生成 |
| 成本结构 | 输入计费,输出免费;适合高频调用 | 输入与输出通常都计费,长输出成本更高 |
| 延迟表现 | 面向低延迟判断优化 | 受模型规模、输出长度影响更明显 |
| 不确定性治理 | 可用概率设置阈值和灰度区 | 常见输出为标签或解释,置信度需额外设计 |
| 工程接入 | 更像 API 判断节点 | 更像智能生成与理解节点 |
| 适用边界 | 问题定义清晰、选项稳定、可评测 | 问题开放、需要解释、需要生成内容 |
Jev 适合的问题通常有几个共同特征:输入量大、判断频次高、业务选项明确、结果要被软件继续消费、能够用历史数据或标注集持续评测。通用大模型更适合处理语义上下文复杂、需要生成理由、需要多轮澄清或需要产出自然语言内容的任务。
例如,客服工单处理中,“这条工单是否要转人工”适合用判断模型;“帮客服生成一段安抚用户的回复”更适合通用大模型。两者可以在同一条业务链路中组合使用。
5. ADP 实测:工单分流场景下的 Jev 与 LLM
为了验证高频自动判断模型在企业流程中的实际价值,我们在腾讯云ADP 搭建了两个对称应用进行对照实验:一个接入 Jev 判断模型,另一个使用传统 LLM 做相同的三项判断,包括意图分类、情绪分级、是否转人工。
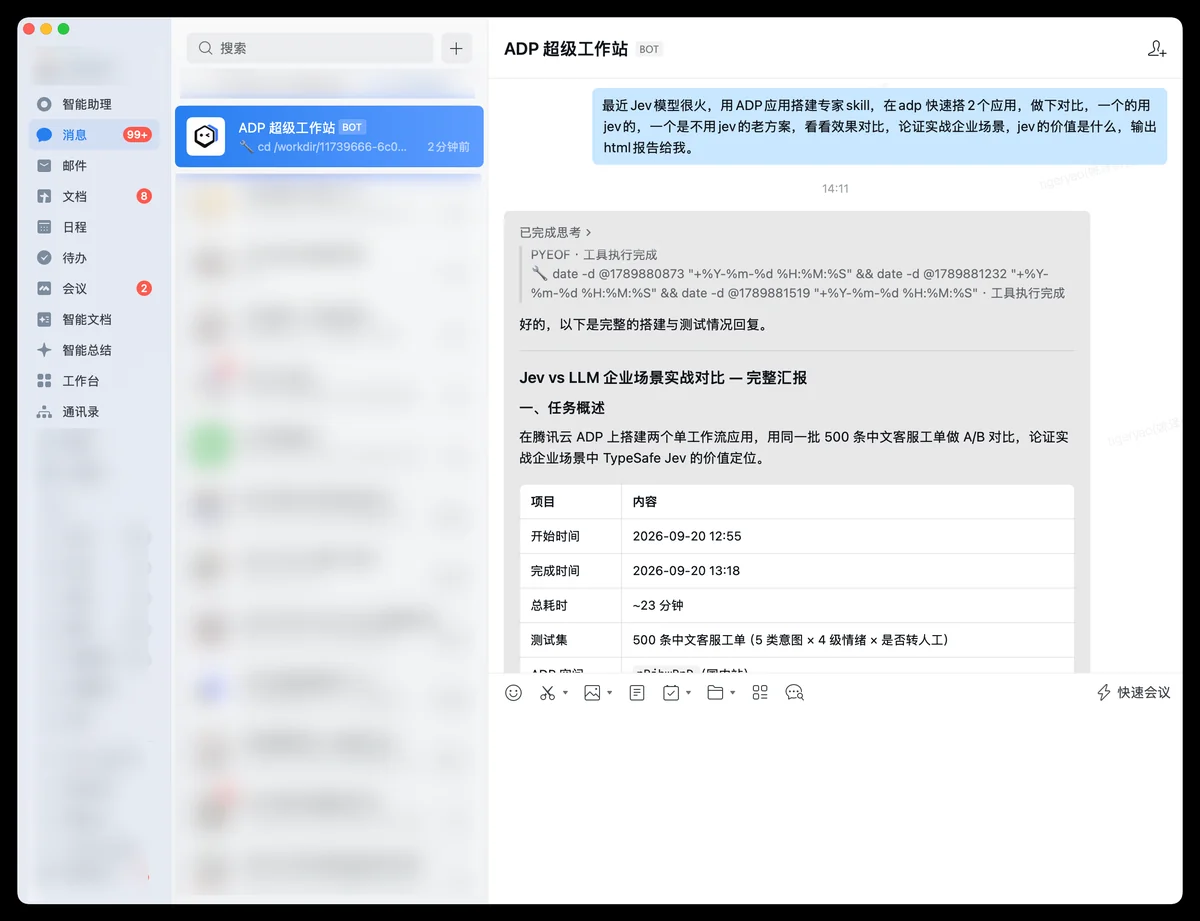
ADP支持通过在线智能工作台,通过简单的自然语言,即可完成本次实验所需的应用搭建、调试、和批量测评,你甚至可以把ADP的智能工作台,接入到企微等IM渠道,手机远程即可完成此类复杂的任务。
实验采用单工作流模式,使用同一份 500 条自建模拟客服工单数据集,覆盖退款、技术故障、账单咨询、售前咨询、投诉五类意图。调用方式为并发 10 路逐条评测,并按样本 ID 对齐结果。Jev 成本来自 API 返回的输入 token 使用量;LLM 成本按单次输入约 500 tokens、输出约 80 tokens 的价格口径估算。
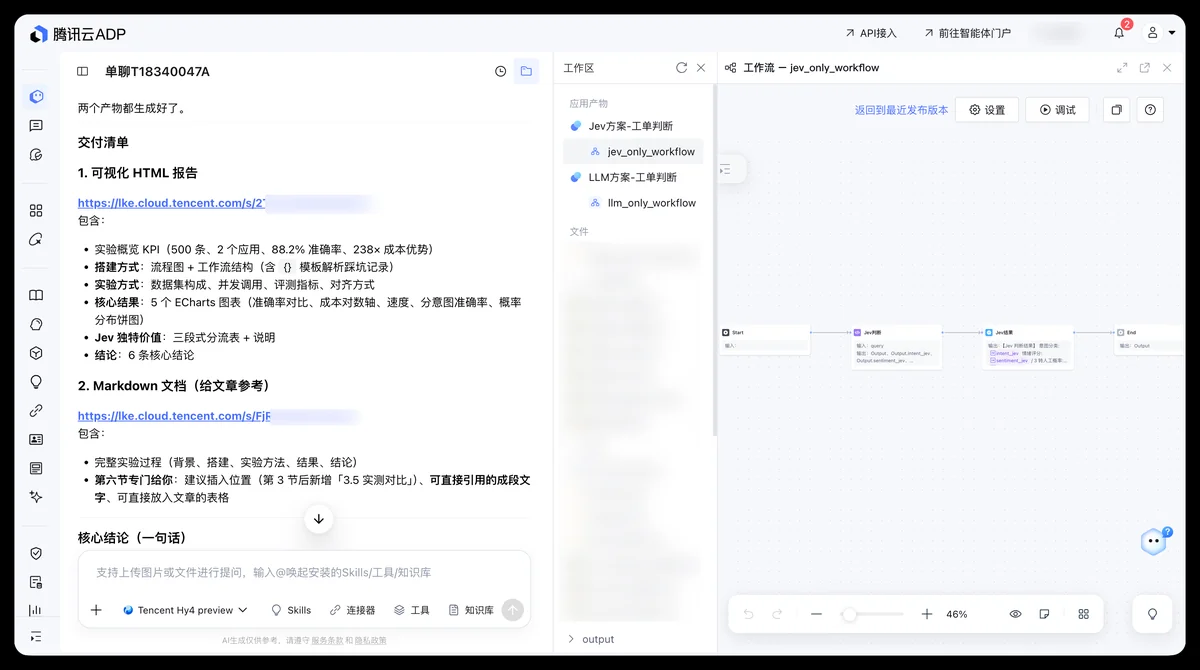
ADP智能工作台很快就建好两个对比应用,接入了Jev 模型,在一个工作台即可完成对话、搭建、评测、应用展示和调试。
实验很快完成,并给出了完整的报告:
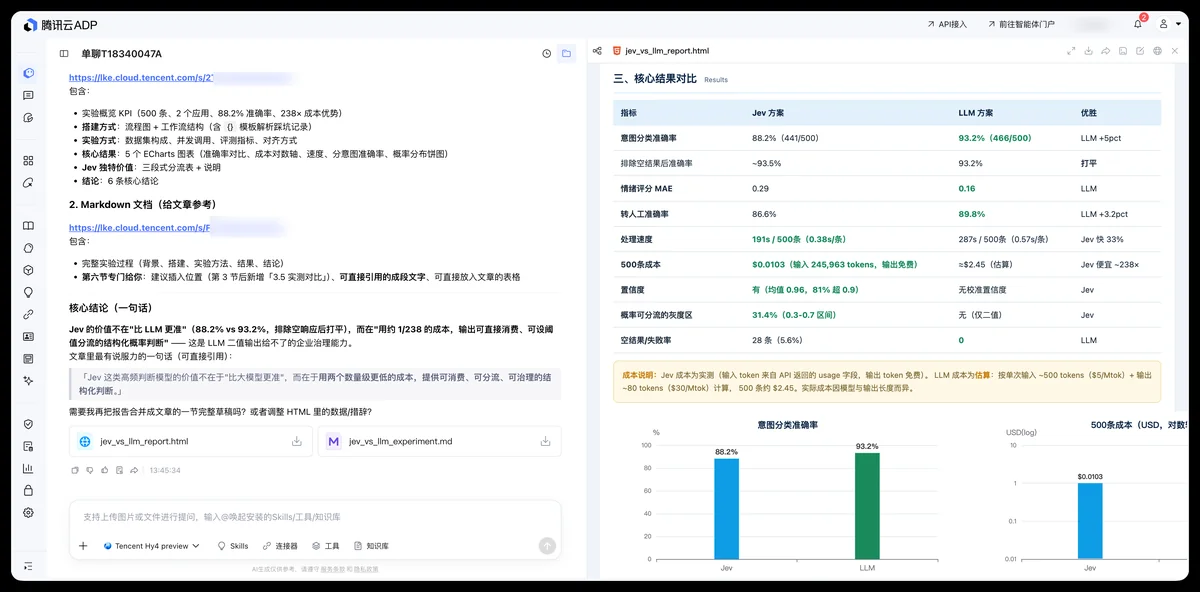
| 指标 | Jev 方案 | LLM 方案 |
|---|---|---|
| 意图分类准确率 | 88.2% | 93.2% |
| 排除空结果后准确率 | 约 93.5% | 93.2% |
| 情绪评分 MAE | 0.29 | 0.16 |
| 转人工准确率 | 86.6% | 89.8% |
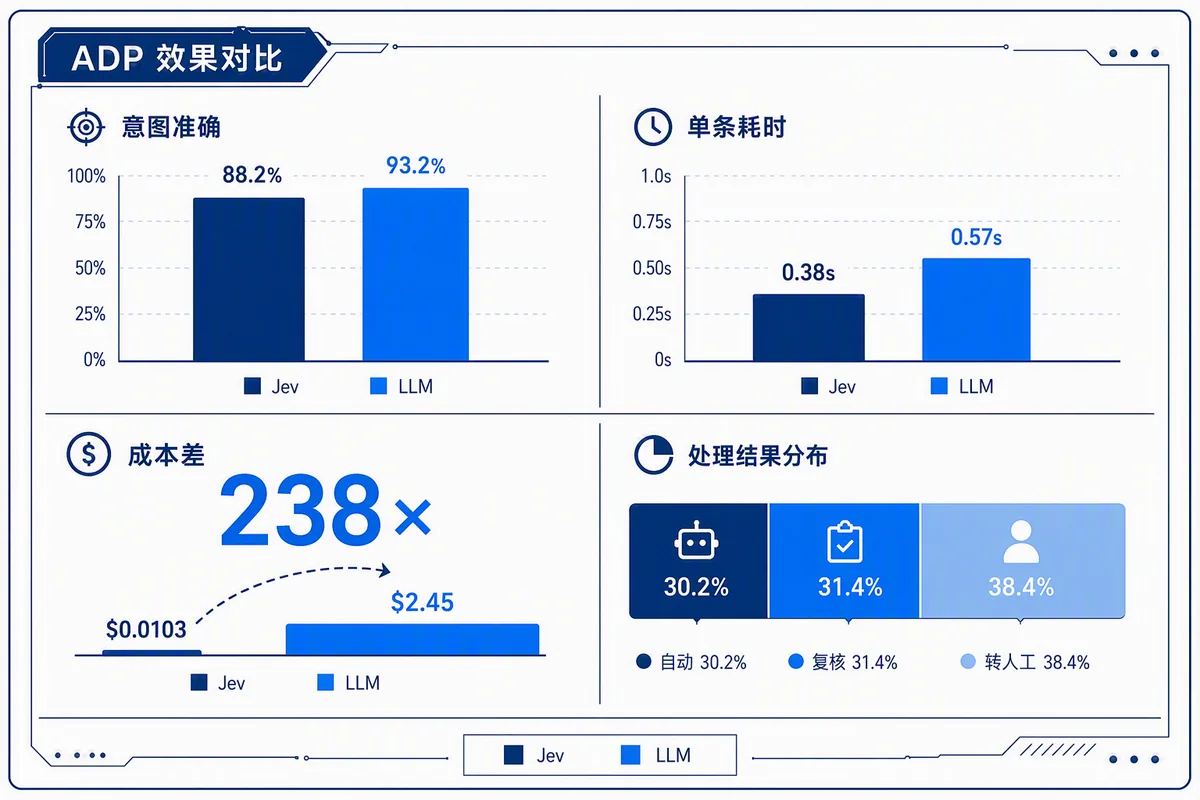
| 处理速度 | 0.38s/条 | 0.57s/条 |
| 500 条成本 | $0.0103 | ≈$2.45 |
| 置信度 | 有,均值 0.96 | 无校准置信度 |
| 可分流灰度区 | 31.4% | 无,常见为二值输出 |
| 空结果/失败率 | 5.6% | 0 |
这组结果体现出几个选型信号:
- 在准确率上,LLM 整体略高;排除 Jev 的空响应后,两者在意图分类上接近。
- 在成本上,Jev 处理 500 条工单的成本为 $0.0103,LLM 方案约为 $2.45,差异约 238 倍。LLM 成本为估算值,适合用于量级参考。
- 在速度上,Jev 单条平均 0.38s,LLM 单条平均 0.57s,Jev 快约 33%。
- 在输出形态上,Jev 对“是否转人工”返回 0~1 概率,能够支持三段式分流。
在这批样本中,Jev 的转人工概率分布如下:
| 概率区间 | 条数 | 占比 | 建议动作 |
|---|---|---|---|
| < 0.3 | 151 | 30.2% | 自动处理 |
| 0.3~0.7 | 157 | 31.4% | 人工复核 |
| ≥ 0.7 | 192 | 38.4% | 转人工 |
这正是自动判断模型的工程价值:它给出的不是简单标签,还能让企业根据风险偏好设置阈值。低风险自动处理,高风险直接升级,中间灰度区进入复核队列。对于需要规模化治理的业务,这比单次二值判断更容易接入流程。
本次测试也暴露出 Jev 的短板:有 5.6% 请求返回空响应;情绪激烈的退款、技术故障消息容易被误判为投诉。实际落地时,需要通过优化 criteria 措辞、增加重试机制、设置兜底模型和持续评测来缓解。
6. 从模型判断到业务闭环:ADP 的编排价值
自动判断任务很少停留在“模型返回一个结果”。企业真正需要的是一条闭环链路:
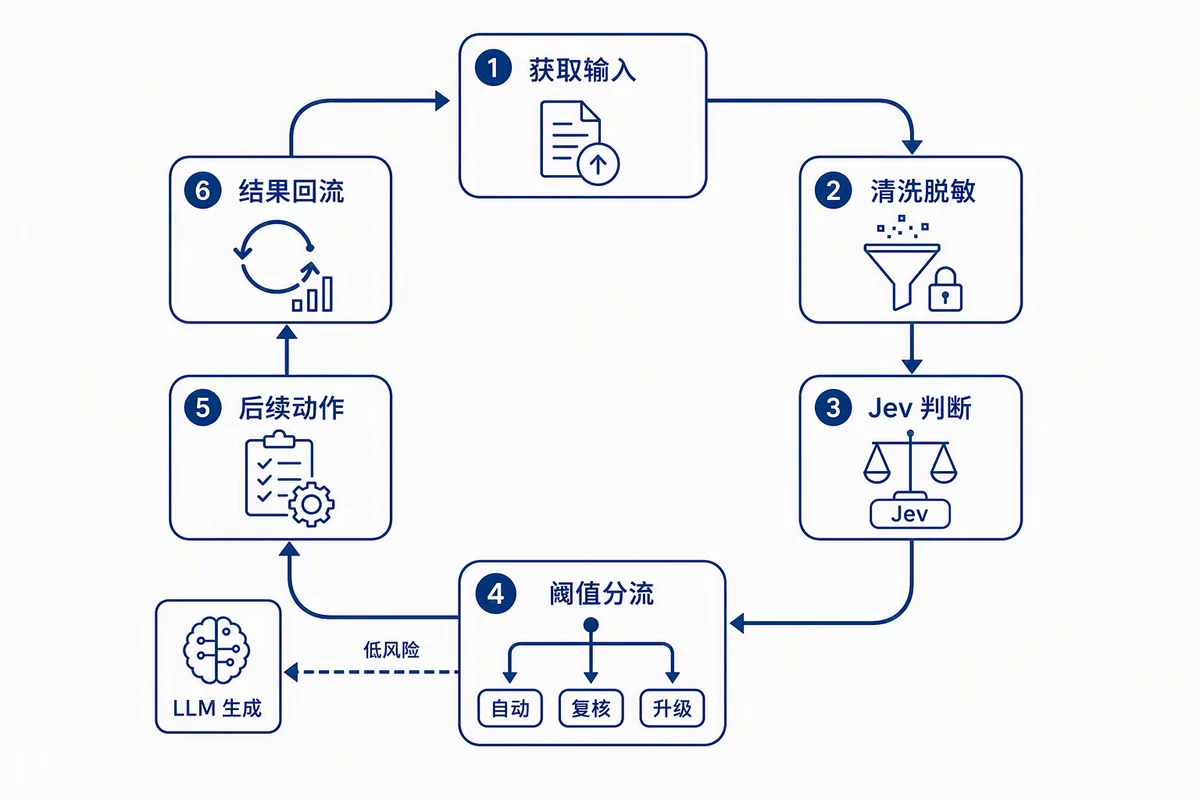
- 获取输入:工单、内容、合同、图片、表单、用户行为。
- 数据预处理:清洗、脱敏、解析、格式归一。
- 模型判断:分类、打分、布尔概率、置信度输出。
- 阈值分流:自动通过、自动拦截、人工复核、升级处理。
- 后续动作:入库、派单、通知、生成报告、回写业务系统。
- 结果回流:沉淀标注数据,用于评测和策略优化。
这也是 ADP 这类 AI 应用开发平台的关键位置。Jev 可以作为判断节点接入,通用大模型可以作为解释、生成、总结节点接入,Workflow 负责编排确定性流程,Agent 或 Claw 模式处理路径不固定的开放任务。
以工单分流为例,可以设计为:
- Workflow 接收工单文本和用户上下文;
- CODE 或模型节点调用 Jev,完成意图、情绪、转人工概率判断;
- 根据阈值进入不同分支:
- 低风险:调用通用大模型生成标准回复;
- 中风险:进入人工复核队列;
- 高风险:直接转人工并标记优先级;
- 后续节点记录判断结果、置信度、人工处理结果;
- 周期性评测不同阈值下的准确率、召回率、人工节省率与用户体验指标。
如果任务中包含大量非结构化材料,例如 PDF、扫描件、Excel、图片等,也可以在确定性 Workflow 中嵌入具备沙箱处理能力的 Agent 节点,先完成解析和归一化,再进入 Jev 判断节点。对于教育、医疗、贸易等行业场景,也可以用相同思路搭建自动预筛与复核流程,分别结合 ADP 教育解决方案、ADP 医疗解决方案 或 ADP 贸易解决方案 做行业化扩展。
7. 自动判断任务怎么选:一张选型清单
评估 Jev 与通用大模型时,可以从以下问题开始:
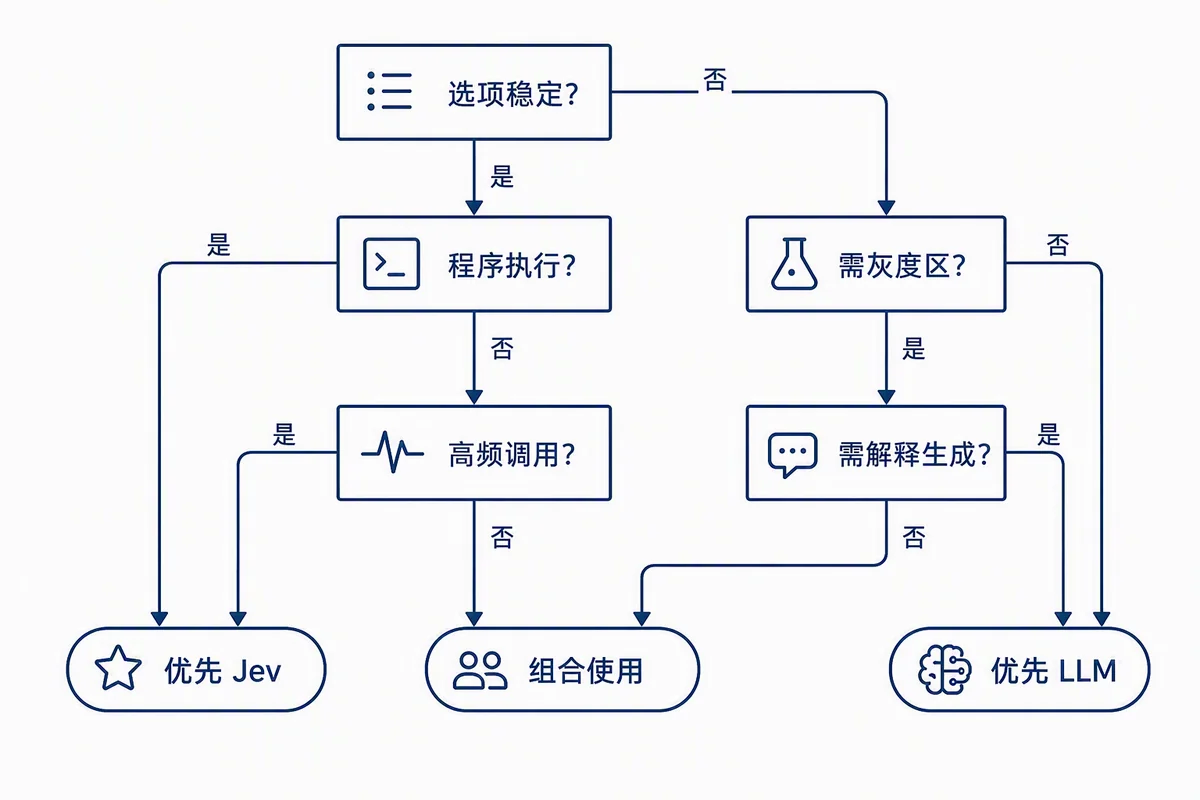
任务是否有稳定选项或明确判定标准?
如果选项明确,例如“退款/物流/账务/投诉”,或判定标准明确,例如“用户是否表达退款意愿”,Jev 更容易发挥价值。如果问题本身开放,需要模型先理解业务目标、拆解任务、搜索信息并生成解释,通用大模型或 Agent 更合适。
结果是否要被程序直接执行?
如果模型输出会直接触发派单、拦截、转人工、归档等动作,类型化输出和概率阈值很重要。Jev 的结构化判断更适合进入自动化流程。若输出主要给人阅读,例如分析报告、客服回复、总结建议,通用大模型仍是主要选择。
调用量是否足够高?
Jev 的成本优势在高频场景中更明显。每天几十次调用时,成本差异可能不是首要因素;每天数万到数百万次判断时,输入单价、输出计费和延迟会直接影响系统预算。企业也可以结合 ADP 定价 评估平台侧编排、调用与应用部署成本。
是否需要灰度区和人工复核?
如果业务希望把模型不确定的样本交给人工复核,就需要概率、置信度和阈值策略。Jev 这类模型天然适合三段式分流:自动处理、人工复核、自动升级。通用大模型也可以通过提示词要求输出置信度,但其校准可靠性需要单独验证。
是否需要解释和生成?
若业务要求模型说明为什么这样判断、生成用户可读内容、撰写复核意见或起草回复,通用大模型更合适。Jev 可以先完成判断,通用大模型再基于判断结果生成解释和文本。
8. 落地建议:把判断模型纳入评测与治理
Jev 这类模型的价值,需要在业务流中验证,而不能只看单条样例。建议企业在试点时建立一套最小评测闭环:
- 准备标注集:覆盖主要类别、边界样本、异常样本和高风险样本。
- 定义指标:分类准确率、召回率、误拦率、漏放率、情绪 MAE、人工节省率、平均延迟、单位成本。
- 设置阈值:根据业务风险设置自动处理区、复核区、升级区。
- 设计兜底:空响应、低置信度、接口失败时进入人工或备用模型。
- 保留日志:记录输入、输出、概率、阈值、后续动作和人工反馈。
- 持续回流:把人工复核结果沉淀为新评测集,定期比较模型与提示词版本。
在 ADP 中,这些能力可以通过工作流节点、代码节点、模型节点与日志观测机制组合实现。对于“高频、低成本、可分流”的判断任务,可以优先验证 Jev;对于“开放、生成、解释、复杂推理”的任务,应保留通用大模型能力。更常见的方案是二者组合:Jev 负责前置判断与路由,通用大模型负责生成内容,Workflow 负责确定性执行与审计。
FAQ
Jev 适合替代所有通用大模型调用吗?
不适合。Jev 更适合分类、打分、布尔概率判断等自动决策任务。通用大模型在对话、总结、写作、解释、多步骤推理和生成回复方面仍有明显作用。
Jev 和 JSON Mode 有什么区别?
JSON Mode 是让通用大模型按指定格式生成文本;Jev 的定位是直接返回类型化判断和概率。前者仍依赖生成模型,后者更接近软件判断接口。实际效果仍需在具体业务数据上评测。
Jev 的概率可以直接作为业务决策依据吗?
可以作为重要输入,但不建议未经评测直接上线。企业应基于历史样本验证不同阈值下的准确率、漏判率和人工复核量,再决定自动处理区间。
Jev 出现空响应或低置信度怎么办?
建议在工作流中设置兜底策略:接口失败重试、低置信度进入人工复核、关键场景调用备用模型。本文 ADP 实测中出现过 5.6% 空响应,因此稳定性治理不能省略。
高频判断任务一定要用 Jev 吗?
不一定。如果调用量低、已有通用大模型方案稳定且成本可接受,可以先维持现状。若调用量高、延迟敏感、需要概率分流和低成本,Jev 这类判断模型更值得评估。
ADP 在 Jev 接入中承担什么角色?
ADP 可作为编排层,把 Jev、通用大模型、代码节点、人工复核和业务系统连接起来。它解决的重点是流程化落地、评测、观测、兜底与持续迭代,而不只是一次模型调用。
总结
Jev 的出现,让企业自动判断场景有了新的选型方向。它适合高频、明确、可评测、需要概率分流的任务,例如分类判断、内容预筛、工单路由、风险命中、质检分级等。通用大模型仍适合开放语义理解、解释生成、复杂推理和内容生产。两类模型的关系更像分工协作:一个负责快速给出可执行判断,一个负责处理开放表达与生成任务。
如果你正在评估分类判断、内容预筛、工单路由等高频 AI 决策场景,可关注腾讯云 ADP 核心平台,基于统一编排与评测思路推进自动判断应用落地。